김진완 포트폴리오 | Frontend Engineer
About
2023년 9월부터 이마고웍스에서 AI 기반 치과 CAD/CAM SaaS인 Dentbird의 프론트엔드를 맡고 있습니다. 구독·결제, 3D 뷰어, 외부 CAM 연동처럼 외부 의존이 많은 복잡한 화면을 만듭니다. AI로 코드가 빠르게 바뀌는 환경에서도 안전하게 개발할 수 있도록 아키텍처·디자인 패턴·상태관리와 검증 체계를 설계하는 것이 일의 중심입니다. 동시에 그 프론트엔드의 기반이 되는 모노레포·환경 분리·빌드·품질 자동화 같은 플랫폼 토대까지 한 제품 안에서 폭넓게 다뤄 왔습니다. 아래는 그중 대표적인 작업들의 배경·판단·회고입니다.
Skills
 React
 TypeScript
 Next.js
 TanStack
Query
 Three.js
 Electron
 Playwright
 Jest
 Docker
 AWS
 GitHub
Actions
 Datadog
계정·구독 클라이언트 아키텍처 — FSD·컴포넌트 패턴과 도입 기준
2023.09 ~ 2025.07 ·
React · TypeScript · FSD
성과 — CaseInfo 다이얼로그가 3개 앱에 중복돼 Compound Component로 단일화, 약 66%(984→330줄) 감소. FSD·디자인 패턴의 도입 기준을 팀에 정립
문제
계정·구독 클라이언트를 입사 초기부터 오래 맡았는데 코드 컨벤션이 구체적으로 정해져 있지 않았습니다.
- 훅과 컴포넌트의 분리 기준, 파일 위치, 중복 처리 기준 부재
components·hooks같은 역할 단위 폴더라 만들기는 쉬우나 그 훅이 어디서 왜 쓰이는지 드러나지 않음- 같은 목적의 코드가 여러 곳에 분산
- 폴더 구조를 여러 번 바꿨으나 기준이 없어 곧 원형으로 회귀
해결 — 구조·패턴을 함께 정리
구독제 전환으로 기존 로직과 분리된 기능을 새로 시작할 기회가 생겨 팀과 공감대를 이룬 뒤 FSD를 도입했습니다.
- FSD 레이어 규칙 정립 — 폴더 역할과 도메인 데이터
분리,
{Domain}API+ query key factory, DTO와 도메인을 잇는 mapper 분리 - Compound Component·Render Props로 관심사 분리. 단점(Context 리렌더 비용, “커스텀 훅과 props로도 가능”)까지 함께 기록하고 관심사 분리가 목적일 때만 적용하는 기준 수립
- 서버·클라이언트 상태 분리 컨벤션을 팀 규칙으로 정의 (TanStack Query 데이터를 useState로 복제하지 않기 등)
적용 사례는 둘입니다. CaseInfo 다이얼로그는 3개 앱에 중복돼 있어 Compound + FormProvider 단일 컴포넌트로 추출해 약 66%(984→330줄) 줄였습니다. 통신 방식(Custom Protocol과 HTTP)은 나중에 한쪽으로 굳히기 쉽도록 전환 지점만 추상화하되 약간의 중복은 의도적으로 허용했습니다.
회고
한계가 분명했습니다. FSD를 도입했는데도
widgets·pages처럼 UI 단위가 레이어에 섞여 “이
파일을 어디 넣을지”가 풀리지 않았습니다. 그걸 정하느라 작은 논의가
이어졌습니다. 디자인 패턴도 “코드 일관성”이라는 명분으로 굳이 필요하지
않은 곳에 적용한 경우가 많았습니다. 제안한 방향을 팀원들이 다르게 이해해
같은 패턴을 쓰는 방법이 갈라지기도 했습니다. 가장 크게 깨달은 것은
디자인 패턴이 어떤 문제를 푸는지 정확히 이해하지 못한 채 도입했다는
점입니다.
그래서 지금은 기술을 도입할 때 우선순위 높은 문제를 먼저 정의하고 대안을 비교해 맞을 때만 팀이 같은 이해를 가진 상태에서 도입합니다. 효용뿐 아니라 도입 비용(커뮤니케이션·마이그레이션·과도기 복잡도)까지 따져야 한다는 것도 이때 알았습니다. 구조 자체가 나빴던 것은 아닙니다. 그 코드는 모노레포로 옮겨간 뒤에도 남아 있습니다. 이 작업에서 배운 것은 ’좋은 구조’보다 ’도입의 전제’였습니다.
케이스 목록 썸네일 로딩 최적화 — 지연 로딩·요청 배치·실패 캐싱
2025.10 ~ 2026.06 ·
React · TanStack Query · IntersectionObserver · Context API
성과 — 운영 중 발생한 무한 재요청 회귀를 공유 캐시 구조로 근절(재마운트돼도 중복 요청 없음을 회귀 테스트로 고정), 썸네일을 지연 로딩과 요청 배치로 최적화해 “N장 = N요청” 구조를 해소
문제
케이스 목록은 사용자가 가장 자주 보는 화면이고 썸네일이 수십 장 표시됩니다.
- “N장 = 네트워크 N요청”이 되기 쉬운 구조
- 운영 중 깜빡임과 무한 재요청 발생
- 원인 — 카드가 재마운트될 때마다 훅이 새로 생겨 같은 썸네일을 중복 요청
- 403 같은 영구 오류도 새 URL로 계속 재요청
해결
- IntersectionObserver로 viewport에 들어온 썸네일만 로드. 50ms 윈도우 안의 요청을 모아 한 번에 배치 요청하는 공통 훅(Context Provider 기반) 구현
- 캐시를 카드 바깥 Provider로 끌어올려 모든 카드가 공유해 재마운트에도 캐시 유지
- 성공(4분)뿐 아니라 실패(10초)도 캐시 — 영구 오류를 짧게 기억해 재마운트 시 네트워크 재호출 없이 즉시 “No data” 처리
- 단일 마운트 안의
onError폭주를 억제하는 재시도 1회 제한을 보조 장치로 배치, 성공 시 실패 횟수를 초기화하면 같은 영구 오류가 반복되므로 의도적으로 초기화하지 않음 - 깜빡임은 로딩 상태를 첫 요청에만 토글하고 재시도는 silent로 처리해 제거
- 회귀 테스트로 “같은 Provider 안에서 재마운트돼도 중복 요청 없음” 검증
회고
무한 재요청은 재시도 횟수만 제한해도 멈춥니다. 하지만 그것은 증상이고 진짜 원인은 재마운트마다 훅이 새로 생겨 캐시가 소실되고 같은 오류를 다시 호출하는 구조였습니다. 재마운트 자체를 없애는 것은 더 큰 공사라 공유 캐시로 우회하는 실용적 선택을 했습니다. 증상을 덮을지 구조를 고칠지 사이에서 비용 대비 효과가 가장 큰 지점을 고른 작업입니다.
설계에서 하나 더 신경 쓴 것은 실패를 다루는 방식입니다. 보통 캐시는 성공만 담지만 여기서는 403 같은 영구 오류도 짧게 캐시했습니다. 실패를 기억하지 않으면 재마운트마다 같은 오류를 다시 호출하기 때문입니다.
B2B 구독·결제 프론트엔드 — 예측 가능/불가능 에러 분리
2023.09 ~ 2025.07 ·
React · TypeScript · TanStack Query
성과 — 모든 에러를 한 덩어리로 처리하던 구조를 예측 가능/불가능 에러로 분리해 한 기능의 실패가 전체 페이지를 중단시키지 않도록 개선(BusinessLogicError·ErrorBoundary 체계는 모노레포 이관 후에도 존속)
문제
일회성 크레딧에서 반복 구독으로 전환하는 시점에 구독·결제 화면(플랜 업그레이드·좌석 구매·취소·재개·쿠폰·결제수단·히스토리)을 전담했습니다. 당시 조직에는 에러 처리 정의가 없었습니다.
- 예측 가능·불가능 구분 없이 모든 에러를 하나의 unknown으로 일괄 처리
- 한 기능에서 발생한 에러가 전체 페이지를 에러 화면으로 전환
- 케이스 목록 조회 1회 실패로 SNB·대시보드 접근까지 차단
- 원인 — 서버가 의도적으로 내려준 비즈니스 에러와 예상하지 못한 시스템 실패를 구분하지 않은 구조
해결 — 에러를 둘로 나누다
- 예측 불가능한 에러는 ErrorBoundary로 격리. 컴포넌트마다 분산된 명령형 방어 코드를 대체하고 실패 허용 범위는 도메인 의존 관계로 구분
- billing 정보를 받지 못해도 결제 내역 조회·구독 취소·뒤로가기는 동작 유지
- 예측 가능한 에러는 코드별 분기 — 서버가
HTTP 200 · success:false · errorCode로 내려주는 비즈니스 에러는 실패가 아니라 의도된 결과이므로 폴백 UI로 뭉뚱그리지 않음 BusinessLogicError커스텀 클래스로 throw하고.when(errorCode, action).otherwise()체인으로 분기- 결제 상태는 서버·Stripe 동기화 기준으로 두고 무한 반복 방지 폴링과 origin이 격리된 결제 팝업으로 외부 연동 실패에 대비
회고
에러 처리는 정교한 도구에서 출발하지 않았습니다. 에러를 구분 짓는
일이 먼저였습니다. 예측 가능한 실패와 불가능한 실패를 나누지 않으면 잘
만든 ErrorBoundary를 두어도 결국 같은 폴백으로 처리됩니다. 이 구조는
모노레포로 이관된 뒤에도 BusinessLogicError와
withErrorBoundary HOC로 남아 있습니다.
다만 조직 차원의 에러 처리 정의는 여전히 없습니다. 무엇이 실패해도 무엇은 살아남아야 하는가를 결제 데이터 의존 관계까지 끊어내는 설계는 당시 출시 우선순위와 설계 역량의 한계로 끝까지 가지 못했습니다. 이 문제의식은 이후 관측·복원력 표준화에서 조직 차원으로 이어갔습니다. 서버가 에러 응답 형식을 HTTP 200에 success:false로 내려줄지 4xx·5xx로 내려줄지부터 합의가 필요했습니다. 에러 처리는 프론트엔드 혼자 정할 수 없고 서버와의 계약이 전제였습니다.
관측·복원력 표준화 — 5개 앱 에러 추적·복원
2026.04 ~ ·
React · TypeScript · Datadog RUM
성과 — RUM에서 한 줄로 뭉쳐 보이던 실패 124건을 원인별로 추적 가능하게 직렬화, 5개 앱 에러 처리를 공통 표준으로 정렬
문제
에러는 잡히지만 어디서 왜 발생했는지 추적되지 않았습니다.
- 여러 fail mode가 같은 UI·같은 메시지로 뭉개짐
- QA 환경 RUM에서 124건의 실패가
new Error('failedToExportMeshes')한 줄로 collapse - 원인 추적 불가
해결
- Root → Section → Feature 3계층 ErrorBoundary 체계 설계 — 에러를 계층별로 격리하고 5개 앱을 같은 표준에 맞춤(계층 적용 깊이는 앱별 단계적)
- 에러를 Datadog 관측 표준에 맞춰 직렬화 — 한 메시지로 뭉쳐 보이던 실패 124건이 원인별로 추적 가능해짐. 적용 전후는 격리 환경에서 RUM 데이터를 정량 비교해 검증
- 안전망은 발생 위치만 자동 표기하고 의미 부여는 호출자가 명시하도록 책임 분리
- 최상위 안전망에는 외부 의존을 두지 않아 안전망이 자기 의존성 때문에 실패하지 않도록 설계
render-time 에러는 react-error-boundary로 처리하지만
비동기 에러에는 이 라이브러리를 쓰지 않았습니다.
- 실제 실패는 렌더가 아니라 async 이벤트 핸들러(파일 다운로드·파싱)에서 발생하는데 이 라이브러리는 render-time 에러만 포착
- iframe 안 모듈의 boundary는 host까지 전파되지 않음
- throw 지점마다 wrap 코드가 늘어 피하려던 분기 증식이 반복됨
대신 비동기 에러는 에러 객체 자체에 metadata를 담는 방식(표준
Error.cause와 구조화된 실패 상세)을 택했습니다. throw
지점은 한 줄로 두고 RUM에는 grep 가능한 단일 라인으로 직렬화했습니다.
공통 라이브러리라 한 곳을 고치면 5개 앱에 반영됩니다.
에러 판별도 라이브러리에 종속되지 않게 분리했습니다.
instanceof로 판별하면 라이브러리마다 타입이 달라 분기가
복잡해집니다. 에러 객체의 형태(shape)만 보고 HTTP 상태를
추출해 axios·fetch·커스텀 wrapper 어디서 온 에러든 같은
기준으로 다뤘습니다. 이렇게 뽑은 상태로 에러를 일시적 오류·치명적
오류·무시할 오류 등 여섯 갈래로 나눠 분류별로 대응했습니다. 이 분류
로직은 한 앱에서 만든 뒤 공통 라이브러리로 옮겼습니다.
회고
관측은 에러를 잡는 일에 그치지 않고 왜 발생했는지 추적할 수 있게 만드는 일이었습니다. 한 줄로 뭉쳐 보이던 124건을 원인별로 가른 것이 그 출발이었습니다.
안전망 설계에서 가장 크게 배운 것은 최후 안전망일수록 외부 의존이 없어야 한다는 점입니다. 처음엔 ErrorBoundary의 fallback UI에 회사 디자인 시스템을 그대로 썼습니다. 디자인 시스템에 큰 변경이 생기자 그 fallback UI 자체가 에러를 발생시키며 흰 화면만 남았습니다. 그래서 최상위 fallback은 의존성을 최대한 제거한 UI로 다시 만들어 가장 바깥 레이어에 뒀습니다. 직접 만든 7분류 에러 체계가 특정 앱에 치우쳐 있던 것도 인정하고 팀 공통 표준에 맞춰 폐기·정렬했습니다.
3D 렌더링 품질 — 마이그레이션 부채 정리와 시각 회귀 테스트
2026.04 ~ ·
Three.js · draco3d · WebGL · Playwright · pngjs
성과 — 시각 회귀 검증을 이벤트 기반 대기로 바꿔 케이스당 120초 → 37.7초, 이미지 맞춤 미세조정 약 1,420줄을 Three.js 표준 기능으로 정리
문제
사내 3D 라이브러리를 Three.js로 옮기는 마이그레이션이 AI 기반으로 빠르게 진행됐습니다. 그 과정에서 “기존과 똑같이 보이게” 두 엔진의 렌더 결과 이미지를 맞추는 방식으로 구현된 부분이 남았습니다.
- 색·조명이 특정 미세조정 값에 기대어 구현. 조건이 조금만 바뀌어도 어긋남
- 3D 렌더 회귀는 일반적인 Playwright 픽셀 비교로는 GPU 차이에 묻혀 포착되지 않음
해결
- 미세조정 값을 표준 기능으로 대체 — 이미지 맞춤으로 들어간 색·조명 값을 원본 엔진의 실제 동작·구현을 근거로 Three.js 표준 기능으로 1:1 대체. 미세조정 값과 메인 스레드 디코더 등 약 1,420줄 정리
- 소스 엔진을 역추적해 표준 기능으로 매핑 — 보철이 스캔 위에 겹쳐 보이는 z-fighting을 처음엔 레이어 순서 문제로 보고 조정했으나, 한쪽 mesh를 그리지 않는 실험으로 겹친 geometry가 근본 원인임을 확정
- 원본 엔진이 depth를 직접 미는 방식을 쓴 이유(16비트 depth 정밀도 한계)까지 코드로 확인한 뒤 GLSL을 새로 쓰지 않고 Three.js 표준 기능(displacementMap으로 vertex를 균일하게 미세 inflate)으로 같은 효과 구현
- opaque/transparent로 갈라져 있던 정책을 모드 무관 단일 정책으로 통합 — 함수 한 곳만 고치면 모든 호출처에 반영
- 시각 회귀를 결정적으로 측정 — 채널별 평균 픽셀 차이를 metric으로 정의한 초기 도구는 국소적 어긋남을 놓쳤음. 격리 컨테이너에서 baseline을 고정 생성(소프트웨어 렌더러로 CI·로컬 GPU 차 제거)하고 Playwright 스크린샷 비교로 전환
- 고정 대기를 이벤트 기반 대기로 바꿔 케이스당 검증 시간 120초 → 37.7초
썸네일이 본 화면과 미묘하게 다르던 것도 legacy 픽셀을 맞추려 남긴 보정값이 그사이 통일된 기준과 갈라진 탓이라 같은 원칙을 적용했습니다.
검토 후 보류한 결정 — 그리고 뒤집힌 전제
VTK는 modeler·crown·milling의 핵심 렌더 엔진입니다. 그중 썸네일 생성 부분만 Three.js로 통합하자는 제안이 있었습니다.
- VTK가 핵심 엔진으로 남아 있어 썸네일만 옮겨도 번들 감소 0임을 소비처를 확인해 검증
- 저장 후 재캡처는 mesh를 다시 받는 왕복이 늘어 악화 방향임을 코드 경로로 확인
- “안 하는 것이 낫다”를 데이터로 정당화하고 “생성은 VTK, 사후 재캡처는 Three.js”라는 책임 경계로 남김
이 경계는 약 일주일 뒤 전제가 바뀌며 수명을 다했습니다. 썸네일 생성이 서버로 오프로드되면서(Node 환경엔 canvas가 없어 VTK가 빈 이미지를 생성) batch 썸네일이 Three.js로 완전 통합됐습니다. ’안 하는 결정’은 그 시점의 전제에 묶인 판단입니다. 전제가 바뀌면 다시 뒤집는 것이 맞다는 점까지 포함해 기록으로 남겼습니다.
회고 · 기여 범위
이 케이스에서 담당한 부분은 마이그레이션 결과물의 이미지 맞춤 부채를 식별·정리하고 회귀를 검증하는 작업입니다(현재 진행). 결과 이미지를 맞추는 빠른 마이그레이션은 미세조정에 기대어 취약합니다. 소스 엔진의 동작을 이해해 타깃 엔진의 표준 기능으로 옮겨야 조건이 바뀌어도 어긋나지 않습니다.
기업 랜딩 풀스택 — 타입세이프 i18n으로 번역 오류 차단
2023.09 ~ 2025.10 ·
Next.js · i18n · Fastify · MongoDB
성과 — 타입세이프 i18n으로 번역 키 오류를 런타임이 아닌 빌드 타임에 차단, 성능·SEO를 포함한 기업 랜딩 v3를 풀스택 단독 리뉴얼
문제
입사 첫 업무로 기업 랜딩을 단독 리뉴얼해 이후 2년 넘게 화면부터 서버 API까지 운영했습니다.
- 번역 키 오타가 런타임에야 드러남
- 잘못된 키나 누락된 키가 배포 후에 발견
해결
- 영어 로케일(
locales/en)을 단일 소스로 타입 정의를 자동 생성 - 그 타입을 i18next에 주입해 존재하지 않는 키는 호출 시 컴파일 에러
- 키를 추가·삭제하면
tsc --noEmit에서 즉시 검출
회고
“런타임에야 드러날 문제를 빌드 타임으로 당긴다”는 원칙은 이후 결제·테스트·관측까지 일하는 방식의 공통 축이 됐습니다.
다만 타입 체크가 만능은 아니었습니다. 그 점은 뒤늦게 배웠습니다. 같은 방식을 본 앱에 넓힐지 검토하며 그동안의 i18n 버그를 직접 집계해봤습니다. 정작 가장 흔한 ’번역 키 노출’은 영어 단일 소스로 만든 타입 체크가 잡지 못하는 부분이었습니다. 언어별 키 누락이라 더 싸고 정확한 방법은 언어 간 키 parity 체크였습니다. 도구는 좋아 보이는가가 아니라 무엇을 막는가를 데이터로 따져 선택해야 한다는 것을, 직접 도입했던 방법을 스스로 점검하며 확인했습니다.
웹·로컬 CAM 연동 Electron 데스크톱 앱 — Dentbird Linker
2024.07 ~ 2025.12, 이후 단독 운영 ·
Electron · React · TypeScript · Datadog
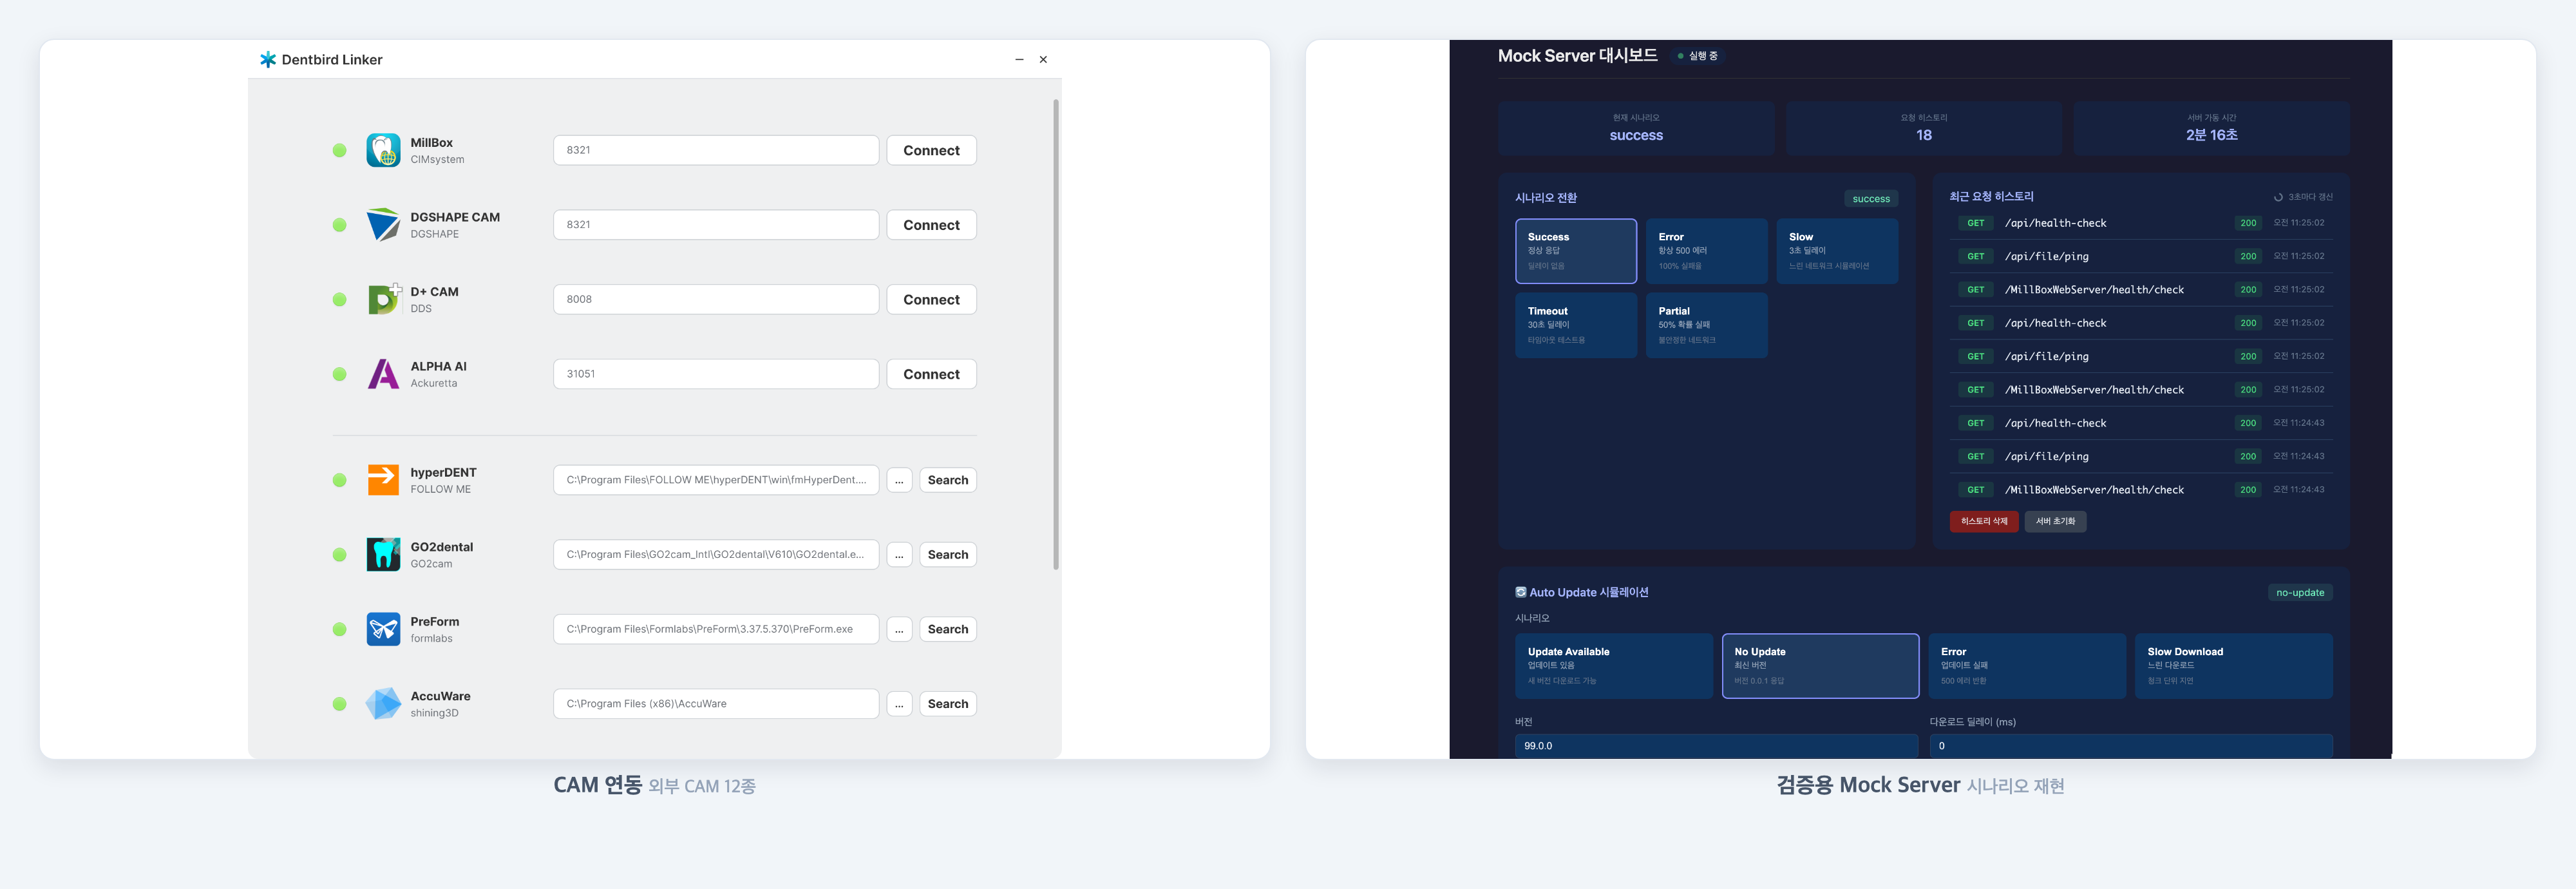
성과 — 좌표계·전달 방식이 제각각인 외부 CAM 12종을 단일 연동 인터페이스로 통합, 앱마다 다르던 설치 감지 타임아웃을 3초로 맞추고 비차단 안내로 통일, Windows 전용 CAM을 Mac에서 재현하는 검증 도구로 원인을 우리 쪽과 CAM 쪽으로 구분
문제
사내 연동 앱을 단독으로 설계하고 운영했습니다. Dentbird에서 디자인한 보철 케이스를 사용자 PC의 외부 CAM 소프트웨어로 보내는 앱입니다. 연동은 파일을 전달하는 데이터 채널과 앱 설치·실행 여부를 아는 감지 채널 두 축으로 나뉩니다. 이 케이스는 둘을 모두 다룹니다.
- 기존에는 다운로드 → 압축 해제 → 수동 투입을 거쳐야 했음
- 자체 로컬 서버가 없는 CAM은 연동 자체가 불가능
- Chrome의 LNA(Local Network Access) 정책이 웹에서 로컬로 가는 통신을 차단하며 권한 팝업을 놓친 사용자의 CS 문의 증가
- “지금 되는 방법”을 고르면 정책이 강화될 때 다시 막히는 구조
해결 — 대안 비교 후 장기 안정성 기준 선택
여러 통신 방식을 구현 속도가 아니라 장기 안정성 기준으로 비교했습니다.
| 방안 | 검토 결과 |
|---|---|
| WebSocket 로컬 서버 | 구현은 가장 빠르나 곧 LNA 적용 대상 → 1~2년 후 재차단될 단기 해법, 탈락 |
| HTTPS 로컬 서버 | 인증서·배포 부담 + 같은 LNA 사정 → 탈락 |
| Custom Protocol | HTTP 요청이 아니라 LNA 적용 대상이 아님 → 채택 |
- Custom Protocol을 중간 레이어로 둔 구조로 재설계. 브라우저가 프로토콜로 Linker를 실행하며 세션 정보를 넘기면 Linker가 서버에서 파일을 직접 받아 변환한 뒤 CAM을 실행
- 좌표계·전달 방식이 서로 다른 외부 CAM 12종(프로세스 실행 8종 + 포트 연동 4종)을 하나의 변환·연동 인터페이스로 추상화
- 운영 중 발생하던 정체불명의 ‘unknown error’ 모달은 처음 의심한 요청 페이로드 문제가 아니라는 것을 Datadog 로그 순서로 확인. 실제 원인은 변환 대상에 잘못 섞여 들어간 point cloud 파일임을 로그로 확정
- 명세가 없던 외부 export는 기존 동작 자체를 명세로 고정. CAM으로 보내는 시점의 STL byte snapshot(크기·sha256)을 기록해 특성화(characterization) 테스트로 고정한 뒤 구현을 그 테스트에 통과시키는 방식으로 재구현
- CAM 12종을 설치하지 않고도 검증하도록 Mock Server 구현 — 헬스체크·파일 핑 엔드포인트와 자동 업데이트 응답을 재현하고 성공·에러(500)·지연·타임아웃·부분 실패 시나리오를 버튼으로 전환
재현할 수 없는 환경을 재현 가능하게 — 외부 CAM 진단
연동한 CAM 중 하나에서 보철 가장자리(마진)가 물결처럼 어긋나 들어가는 문제가 접수됐습니다. 이 CAM은 Windows 전용이고 3D 뷰포트가 GPU 렌더라 Mac에서는 결과를 볼 수 없었습니다.
- Windows 빌드머신에 원격으로 접속해 Linker가 실제로 보내는 것과 같은 요청·같은 변환 규칙으로 전송을 재현하는 도구를 만들고 팀이 쓸 수 있게 스킬로 등록
- 조건을 하나씩만 바꿔 대조 — 함께 보내는 마진 정보의 유무, 보철 종류 값 변경
- 확인 결과 이 CAM은 전달받은 마진 정보를 쓰지 않고 항상 형상에서 직접 검출하며 그 검출 방식을 보철 종류 값이 선택. 임플란트 케이스에 자연치용 값이 들어가 있던 것이 원인
- 그 전까지 내린 “CAM 쪽 문제라 고칠 수 없다”는 결론은 테스트용 특이 케이스를 일반화한 것이었고 실제 QA 케이스로 다시 재현해 정정
- 반대 방향의 문의(“여러 개를 보냈는데 하나만 열린다”)는 코드를 전수 확인한 뒤 우리 전송은 정상이고 해당 CAM의 실행 인자가 마지막 하나만 받는다는 것을 사내 벤더 문서에서 확인해 결함이 아님을 근거와 함께 확정
설치 감지 — 감지를 믿지 않는 방향으로
두 번째 축인 감지 채널입니다. 브라우저는 LNA 정책 때문에 로컬 헬스체크로 앱 실행을 직접 확인할 수 없습니다. 창 포커스 변화 같은 휴리스틱으로 추정할 수밖에 없습니다. 두 방향의 오탐이 있었습니다.
false-negative — 앱이 이미 실행 중이면 OS가 기존 창으로 라우팅해 포커스 변화가 없어 ’미설치’로 오인 → 설치돼 있는데 설치 모달 표시
false-positive — 로딩 중 사용자가 DevTools를 열어 포커스가 빠지면 ’설치됨’으로 오인 → 미설치인데 다운로드 안내 억제
감지를 완벽하게 만들지 않고 틀려도 사용자가 막히지 않는 쪽으로 정책 통일
batch 2.5초·Linker 10초로 달랐던 감지 타임아웃을 3초로 일치. 미감지면 미설치로 간주하되 설치 안내를 항상 비차단(non-trapping)으로 표시해 어떤 경우에도 다운로드가 가능하게 함
DevTools로 인한 false-positive는 타임아웃으로 막지 못하는 한계임을 인지한 채 수용
근본 해법으로는 Zoom·Slack 같은 설치형 서비스처럼 감지 판정 자체를 없애고 다운로드 안내를 항상 제공하되 설치돼 있으면 자동 실행되는 방식을 제안해 기획·QA와 합의했습니다. 아직 착수 전입니다.
회고
처음엔 로컬 서버 방식이 핵심이었지만 정책 변화로 더는 쓸 수 없게 됐습니다. 직접 폐기한 뒤 Custom Protocol 기반으로 옮겼습니다. “당장 되는 방법”이 아니라 “정책이 또 바뀌어도 흔들리지 않는 방법”을 골랐습니다. 이 프로젝트에서 가장 중요한 판단이었습니다. 브라우저·OS의 실행환경 정책(LNA, 포커스, 프로토콜 핸들러)이 웹과 로컬의 경계에서 무엇을 막고 허용하는지를 이 과정에서 깊이 이해했습니다.
감지에서도 같은 태도를 얻었습니다. 휴리스틱은 늘 틀릴 수 있으므로 감지를 완벽하게 만들려 애쓰기보다 틀려도 사용자가 막히지 않도록 설계하는 쪽이 더 단단했습니다. 같은 문제가 다시 열리면서 휴리스틱 위에 보강을 더하는 방식으로는 구조적 한계를 넘지 못한다는 것을 겪었습니다. 그래서 감지 판정 자체를 없애는 방향까지 제안했습니다.
Medit 소프트웨어 연동 인앱 현대화 — 방치된 통합을 되살리고 결합을 끊다
2026.07 · Electron · TypeScript · MUI
성과 — 곧 사용이 끊길 뻔한 협력사 인앱을 엔진·로그인·의존 정리로 되살리고 우리 서비스가 바뀌어도 재빌드가 필요 없는 구조로 전환 (실제 Electron과 CDP로 검증 완료, 배포 대기)
문제
협력사 Medit의 소프트웨어 안에서 Dentbird를 쓸 수 있도록 Electron 인앱 형태로 제공했지만 2023년 이후 유지보수되지 않았습니다.
- 그사이 우리 서비스는 인앱을 고려하지 않고 업데이트를 거듭
- 로그인 후 재진입 시 엉뚱한 페이지로 이동, 미로그인 상태에서 작업 저장 실패
- 곧 배포될 버전에서는 인앱에서 서비스를 아예 사용할 수 없는 상황
해결
- 최신 3D 엔진이 요구하는 WASM 기능(JSPI)이 구버전에서 동작하지 않아 Electron 25를 31로 업그레이드해 재빌드
- 로그인 문제의 원인은 인앱이 우리 서비스 내부 방식에 불필요하게
결합돼 있던 것 — 과거 인앱은 유저 정보 API(
get-user) 응답이 200이면 로그인 성공으로 판단했고 이 API를 레거시로 제거하자 판단이 무너짐 - 급한 대로 해당 경로에 같은 이름의 이미지를 항상 내려주는 임시 대응을 한 뒤 확인할 필요도 없던 결합을 IPC 기반 흐름으로 재설계해 제거
- 회사 UI 라이브러리 의존을 MUI로 대체. 해당 라이브러리는 패키지가 GitHub으로 이전되며 설치 경로도 사라진 상태였음
- 브라우저 stub 검증이 불안정해 실제 Electron에 CDP로 접속해 3D 엔진 구동까지 확인
회고
인앱은 C++ 애드인과 함께 빌드되는 구조라 재빌드 자체가 부담이었습니다. 그래서 되살리면서 우리 쪽 구현과의 결합을 줄였습니다. 이제는 서비스의 구현 아키텍처가 바뀌지 않는 한 인앱을 다시 빌드할 일이 없습니다. 결합을 완전히 없애는 데 집착하기보다 큰 변경이 있을 때만 드물게 재빌드하면 되는 선까지 끊는 것을 택했습니다.
두 문제는 해결됐고 릴리스는 협력사 Medit이 맡아 배포를 기다리고 있습니다.
공통 모듈 Micro Frontend — 제약 기반 통합 전략
2023.09 ~ 2025.10 ·
NX · Module Federation · iframe · postMessage
성과 — 4개 서비스에 중복된 공통 기능 4종을 same-origin iframe 단일 구현으로 합쳐 4개월간 유지, 배포 단위와 조직 제약이 바뀔 때마다 통합 방식을 다시 선택
문제
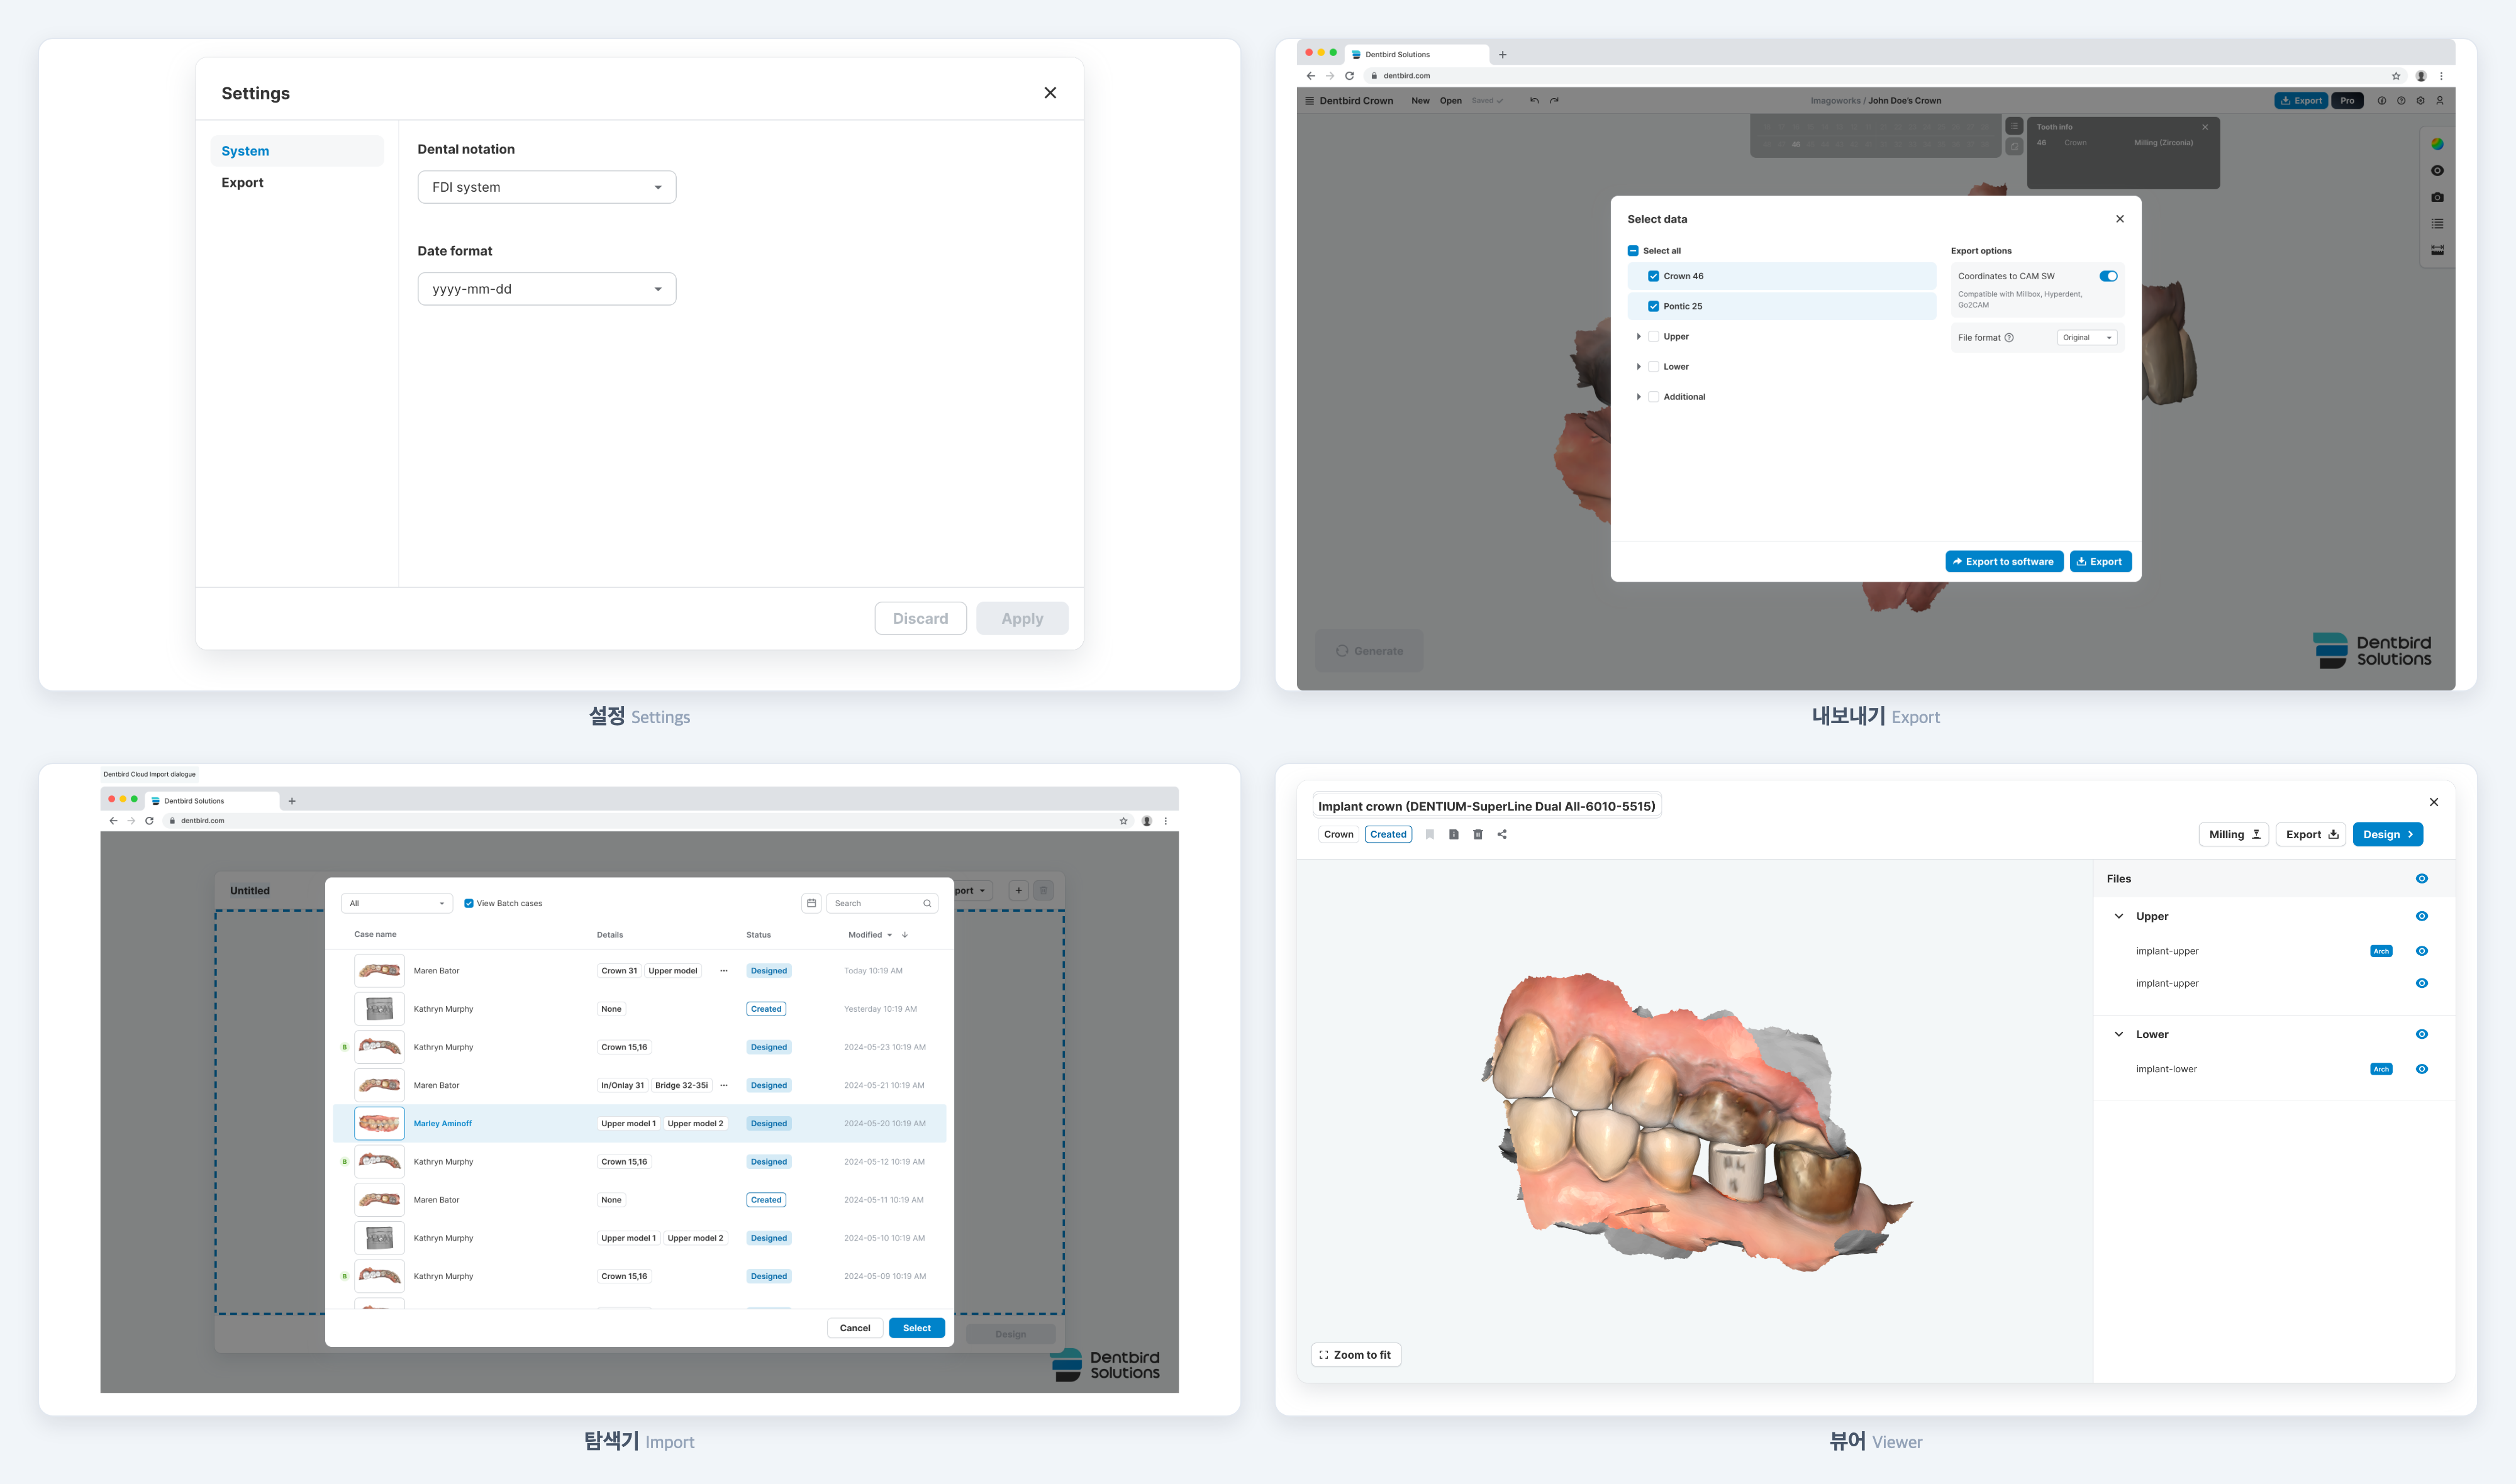
4개 서비스(cloud·crown·modeler·milling)가 공통 기능 4개(설정·내보내기·탐색기·뷰어)를 공유했고 이 기능의 변경 비용이 컸습니다.
- 하나 바뀔 때마다 각 서비스에 같은 수정을 반복하고 전부 배포
- 도메인도 관리팀도 분리돼 있어 변경 한 번의 조율 비용이 큼
해결 — 제약이 바뀔 때마다 다시 선택
- 라이브러리 배포는 각 서비스가 버전업·재배포를 반복해야 해 문제가 그대로 남았음
- iframe + postMessage 런타임 통합 — 가장 빠르고 단순한 선택. 다만 모듈이 각자 도메인을 갖고 들어가 배포도 모듈 수만큼 필요
- 빌드타임 통합 — 모듈이 따로 배포되는 경우는 대부분 독립적인 UI 수정이 아니라 공용 라이브러리 업데이트와 함께 이뤄지는 수정이었음. 4개 앱이 한 모노레포로 합쳐진 것과 맞물려 배포 단위를 줄이는 편이 나았음
- 다시 same-origin iframe — 빌드타임 통합은 통합 배포가 실제로 잘 이뤄지지 않았고 사내 배포 주기 제약으로 부담만 커졌음. cloud 앱의 하위 라우트로 올려 cloud가 배포되면 함께 배포되도록 전환. CORS·인증 공유·origin 검증도 단순해짐
Module Federation도 후보였지만 다른 기능에 적용해본 경험상 초기 설정이 복잡하고 모노레포가 아닌 소비처에서 부담이 커 이 건에서는 제외했습니다. 몰라서가 아니라 적용해 본 뒤 비용 대비 이득으로 판단한 것입니다. console-client에는 Module Federation을 직접 적용했습니다.
회고
같은 문제를 라이브러리 → iframe → 빌드타임 통합 → 다시 iframe으로 세 번 다르게 풀었습니다. 매번 그때 더 낫다고 본 방법을 택했지만 운영해보면 조직·배포 제약이 다른 답을 가리켰습니다. 빌드타임 통합은 기술적으로 깔끔했어도 사내 배포 주기와 맞지 않아 결국 same-origin iframe으로 돌아왔습니다. 이 과정에서 “정답 기술”은 없고 제약에 맞는 선택만 있다는 것을 배웠습니다. 더 나아 보이는 방법이라도 운영해보기 전에는 알 수 없었습니다.
이 통합은 4개월간 공통 기능 4종을 단일 구현으로 유지했고 이후 Vite로 표준이 통일되며 그쪽으로 넘어갔습니다. 별개로 사내 공통 디자인 시스템(MUI 기반)에도 DatePicker 확장(닫힘 핸들러 덮어쓰기 버그 수정·placeholder·클릭 핸들러 노출) 등 공통 컴포넌트 기여와 v3.0.0 릴리스 관리를 했습니다.
프론트엔드 모노레포 통합 — 레포·환경 구성 일원화
2024.06 ~ ·
TypeScript · NX · Git Subtree · i18n
성과 — 조직 변경에 맞춰 앱 2종·라이브러리 6종을 커밋 이력 보존하며 NX 모노레포로 이관하고 버전이 어긋난 공용 라이브러리는 빌드타임에 합쳐 통합 배포·버전 정합을 확보, 잔존 설정이 유발한 OOM도 진단해 빌드 태스크 11→9로 정리
문제
분리됐던 팀들이 합쳐지는 조직 변경이 있었고 레포 구조가 그 변화와 맞지 않았습니다.
- 각자 관리하던 레포가 떨어져 있어 하나의 변경이 여러 PR·여러 배포로 분리
- 공용 라이브러리는 앱마다 버전이 어긋나 배포 시점 조율과 팀 간 커뮤니케이션 비용 발생
- 환경별 URL·도메인 구성이 서비스마다 제각각
- 다국어 관리도 중복 업로드와 분산 스크립트로 파편화
해결
- NX 유지 + OOM 해소 — 모노레포 도구를 새로 고르는
대신 기존 NX 유지(전환 이득이 이관·재학습 비용을 넘지 못한다고 판단).
webpack.config.js가 남아 NX 자동 타겟 추론을 유발했고 여기서 불필요한 산출물과 OOM이 생기는 것을 진단해 빌드 태스크 11개 → 9개, OOM 해소 - Git Subtree로 이관 — 별도 레포의 클라이언트 앱 2종·공용 라이브러리 6종을 메인 모노레포로 옮김. 단순 복사가 아니라 커밋 이력을 보존하고 네임스페이스 충돌은 리네임으로 해소
- 도메인 통합 라이브러리 — 환경별로 분산된 도메인·URL 구성을 단일 라이브러리로 모음. 기준 도메인 하나에서 backend·gateway·테넌트 호스트가 파생되고 통합 도메인에서는 상대 경로, 레거시에서는 환경변수 기반 절대 URL로 갈라지되 호출부는 하나의 형태로 통일
- 다국어 중앙화로 중복 업로드 89줄과 14개 스크립트에 흩어져 있던 i18n 관리를 단일 스크립트로 통합
회고
분산됐던 레포를 하나로 합치니 여러 곳에 걸친 변경을 한 PR에서 한눈에 보고 리뷰할 수 있게 됐습니다. npm 패키지나 외부 모듈로 따로 배포되다 보니 버전이 어긋나 불일치가 생겼습니다. 이것도 빌드 타임에 함께 컴파일하는 방식으로 사라졌습니다.
“무엇을 합칠까”보다 합친 뒤에도 흔들리지 않을 토대(도메인 통합 라이브러리)를 먼저 마련한 것이 다음 단계인 격리 재현 환경의 기반이 됐습니다.
AI로 빠르게 개발하는 팀의 회귀 대응 — 검증 자동화에서 회귀 측정(CFR)까지
2025.11 ~ ·
Docker · Playwright · Claude · 런타임 Config · EC2 · qase
성과 — 명세 검증을 AI로 전량 자동화하려다 비결정성·비용의 한계를 확인하고 격리 재현 위 E2E로 자리 잡음. 정성 평가로는 문제없던 테스트가 실제로는 결함을 잡지 못한다는 것을 mutation testing으로 확인. 그 뒤 배포마다 검증을 통과해 나간 결함을 추적하는 CFR 대시보드를 직접 만들어 팀에서 운영 중
문제 — AI가 개발을 가속하자 회귀가 늘었다
AI 도입으로 코드 변경 속도가 빨라진 만큼 회귀도 함께 늘었습니다.
- 고친 버그가 다시 나오고 한쪽 변경이 다른 쪽을 무너뜨리는 일이 배포마다 반복
- 제품에는 애초에 테스트가 거의 없었음
- 그나마 있는 테스트 대부분은 AI 도입 이후 빠르게 만들어진 것
해결 — 여러 방법을 거친 진화
- e2e 자동화 시도 — 기능 명세가 실제로 검증되는지 확인하려 했으나 e2e를 돌릴 격리 환경도 셋업 코드도 없어 환경 구성에 시간이 소진
- AI가 Playwright MCP로 브라우저를 직접 조작 — 커버리지는 늘었으나 실행할 때마다 결과가 달라지는 비결정성 문제
- 검증 절차를 YAML로 형식화 — 결정성은 확보했으나 e2e 코드보다 실행 시간과 토큰 비용이 큼
- e2e 코드로 회귀 — 격리 재현 환경 위에서 결정론적으로 실행
격리 재현 환경은 앞서 직접 만든 도메인 통합 라이브러리와 런타임 환경 분리 위에서, 특정 커밋 시점의 클라이언트·서버·DB를 그대로 Docker로 띄우는 구조입니다.
- 분산돼 있던 E2E를 한데 모아 반복되던 로그인 셋업을 공통 헬퍼로 약 93% 감소하고 Page Object로 리팩토링
- 8개 앱을 동시에 띄우면 S3 다운로드가 DNS를 포화시켜 실행이 실패하던 문제는, 처음 의심한 포트 충돌이 원인이 아님을 수정 유무를 대조 실행해 확인하고 공유 캐시 프리페치로 해결
- “전체 E2E는 느리고 안 돌리면 회귀를 놓친다”는 문제를 두고 QA팀이 관리하는 수백 개 테스트 케이스를 Planner·Verifier 두 에이전트로 검증하던 자작 도구 TC-Verify를 확장 — 커밋 변경과 관련된 테스트만 AI가 선별해 실행하고 실패를 실제 회귀와 테스트 코드 문제로 1차 분류
그래도 못 잡았다 — 측정부터 다시
이렇게 했는데도 예정된 배포가 품질 기준을 통과하지 못해 밀렸습니다. AI가 만든 테스트를 다시 AI가 평가한 탓이었습니다. 겉으로는 문제없어 보여도 실제로는 결함을 잡지 못하는 테스트가 많았습니다.
- mutation testing으로 측정하니 정성 평가에서 ’A급’을 받은 코어 라이브러리조차 mutation score 57% — 심어 둔 결함의 43%를 테스트가 그대로 통과
- 방향을 바꿔 어떤 결함이 검증을 통과해 배포까지 갔는지를 먼저 보이게 만들기로 결정
- 배포마다 빠져나간 결함을 추적하는 CFR 대시보드를 화면과 API까지 직접 구축해 팀에서 운영 중
- 단순 건수가 아니라 심각도를 함께 보고 임의 기준선 대신 관리 한계로 정상 범위를 판단하며 두 번 이상 발견된 재발 결함까지 한 화면에서 확인
회고
도구를 여럿 거쳤어도 결정성, 그리고 무엇이 개선되고 무엇이 나빠지는지 숫자로 보는 일이 핵심이었습니다. AI는 테스트를 빠르게 만들어 주지만 AI가 만든 것을 AI가 평가하면 못 잡는 결함이 그대로 남습니다. 측정하지 않으면 그것을 끝내 알 수 없습니다. 좋은 테스트는 구현이 아니라 의도한 명세를 검증해야 한다는 점도 이 과정에서 분명해졌습니다.
AI 변경 감지에도 한계가 있었습니다. 어떤 회귀는 오히려 AI 리뷰가 통과시킨 잘못된 테스트에서 나왔습니다. 기획 의도가 코드에도 테스트에도 없이 티켓 코멘트에만 있었던 탓입니다. 직접 바로잡았고 AI를 판단에 쓸수록 그 판단이 맥락 없이 틀릴 수 있다는 전제까지 함께 설계해야 한다는 것을 배웠습니다. EC2 상시 구동의 보안·안정성 부담을 줄이려 변경 감지는 이후 로컬 데일리 E2E로 옮겼습니다.
데스크톱 앱 빌드·서명·배포 자동화 — 로컬 빌드·수동 서명 의존 제거
2024 ~ ·
Electron · electron-builder · electron-updater · GitHub Actions · Azure Pipelines · S3
성과 — 데스크톱 앱 빌드 시간 33~39분 → 17~24분, 업로드 아티팩트 757MB → 334MB(약 56%), Windows 코드 서명을 빌드머신 단독 운영으로 전환(인프라팀 의존 제거)
문제
두 데스크톱 앱(Batch·Linker)의 빌드·서명·배포가 특정 PC와 사람에 종속돼 있었습니다.
- 빌드가 담당자 로컬 PC에서 실행되고 macOS 빌드 시간이 길었음
- Windows 코드 서명은 인프라팀이 보관한 서명 USB가 있어야만 가능
- 그 PC나 담당자가 자리를 비우면 출시가 중단되는 구조
해결
- 빌드를 물리 빌드머신 + self-hosted GitHub Actions로 이관
- Windows 코드 서명 에이전트를 빌드머신에 직접 설치·풀 등록해 단독 운영 — 서명 USB와 인프라팀 의존 제거
- macOS 파이프라인의 빌드 단계를 재설계해 전체 33~39분 → 17~24분, 업로드 아티팩트 757MB → 334MB(약 56%)
되돌린 결정과 도입하지 않은 결정
- macOS 아키텍처 번복 — Universal → arm64 → 다시 Intel로 11일간 3연속 번복. 용량이 2배가 되는 트레이드를 도입·운영·회수까지 직접 감당하며 아키텍처 결정이 용량·호환성·배포로 번지는 방식을 겪음
- 빌드 과정 내 코드 서명 통합은 도입하지 않음 — 인프라팀 개입 없이 개발자가 배포 준비가 끝난 아티팩트를 자율적으로 빌드하고 서명 후 자동 업데이트까지 동작하는 흐름을 만들려 했으나 서명 후 바이너리가 바뀌면 체크섬이 어긋나 자동 업데이트가 실패하는 문제를 확인하고 오히려 번거로워질 것으로 판단해 보류
- blue-green 무중단 배포 — 도입했으나 green 검증 자동화는 환경·빌드가 2배가 되는 운영 비용 대비 가치가 낮다고 보아 보류
회고
운영하면서 두 장애도 직접 겪었습니다. 상시 가동 self-hosted 러너가
빌드 tarball을 /tmp에 남기는데 정리에서 누락돼 나흘간
738개·약 26GB가 쌓여 8개 앱 빌드가 전부 멈춘 적이 있습니다.
/ 디스크는 여유였는데 /tmp만 별도 RAM
파티션이라 진단이 늦었고 정리 단계를 산출물 생성과 대칭으로 맞춰 근본
해결했습니다. GitHub Actions 이관 중에는 Windows 서명 도구 압축 해제가
심볼릭 링크 권한 부족으로 조용히 5회 실패하던 것을 러너 Developer Mode로
해결했습니다.
자동 업데이트가 조용히 실패하던 문제를 추적하다 무결성 검증이 “빌드 시점에 기록된 해시 = 실제 바이너리 해시”라는 전제 위에 선다는 것을 알게 됐습니다. 증상이 아니라 전제를 건드리는 결정(어디서 서명할 것인가)이 곧 업데이트 안정성을 좌우합니다.